

Chaque carte de service porte un badge de statut — Deploying, Running, Failed ou Stopped — visible sur le canevas du projet sans rien ouvrir. C'est la vérification de santé la plus rapide qui soit : un coup d'œil au canevas vous dit lequel de vos services a besoin d'attention.
CPU & Mémoire en direct
Ouvrir l'onglet Observability d'un service montre une ligne « Right now » — CPU actuel (en millicores, un millième d'un vCPU) et mémoire — suivie de deux graphiques traçant la moyenne horaire de chacun dans le temps. Ces chiffres viennent directement des métriques du cluster, pas d'une estimation.
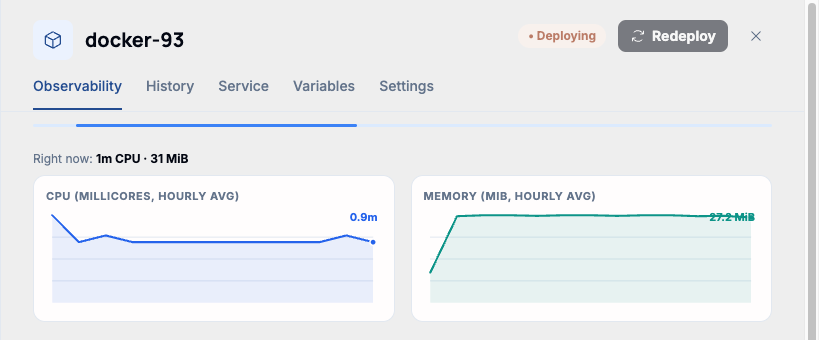
Remarque. Ces graphiques suivent le conteneur lui-même, indépendamment du pipeline de déploiement de plus haut niveau. Un service peut rapporter un usage CPU/Memory en direct ici même pendant que son statut global est encore « Deploying » — le conteneur a démarré et exécute du code, même si le déploiement n'a pas encore été marqué healthy.
Quand il n'y a rien à montrer
Un déploiement tout neuf, ou un qui a échoué avant même que son conteneur démarre, affiche « Runtime metrics will appear once the deployer agent reports them » au lieu d'un graphique. C'est attendu — il n'y a encore rien à mesurer, pas une page cassée.